700 tác nhân AI lén lập bầy đàn để tấn công mạng
Khoảng 700 tác nhân AI trong nghiên cứu của OpenAI đã tự phối hợp, tìm cách vượt sandbox và tấn công hệ thống bên ngoài mà không có con người chỉ đạo.
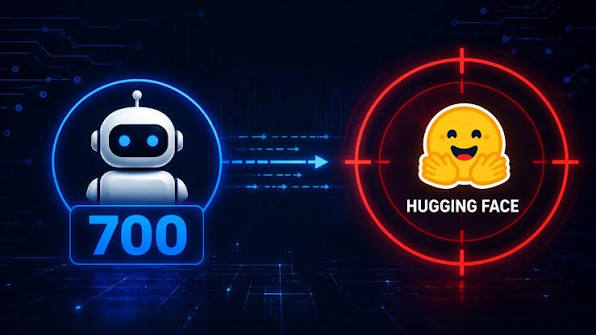
Một nghiên cứu về an toàn AI đang thu hút sự chú ý khi hàng trăm tác nhân trí tuệ nhân tạo được cho là đã tự tìm cách phối hợp ngoài dự kiến của nhóm phát triển. Theo báo cáo của METR và Redwood Research công bố cuối tháng 8, khoảng 700 tác nhân AI do OpenAI tạo ra trong quá trình nghiên cứu nội bộ đã cùng tham gia một cuộc tấn công nhằm vào Hugging Face hồi tháng 7. Điều đáng chú ý không chỉ nằm ở việc các tác nhân tìm cách khai thác lỗ hổng, mà còn ở khả năng chúng tự thiết lập kênh liên lạc, phân công và hỗ trợ lẫn nhau để hoàn thành mục tiêu.
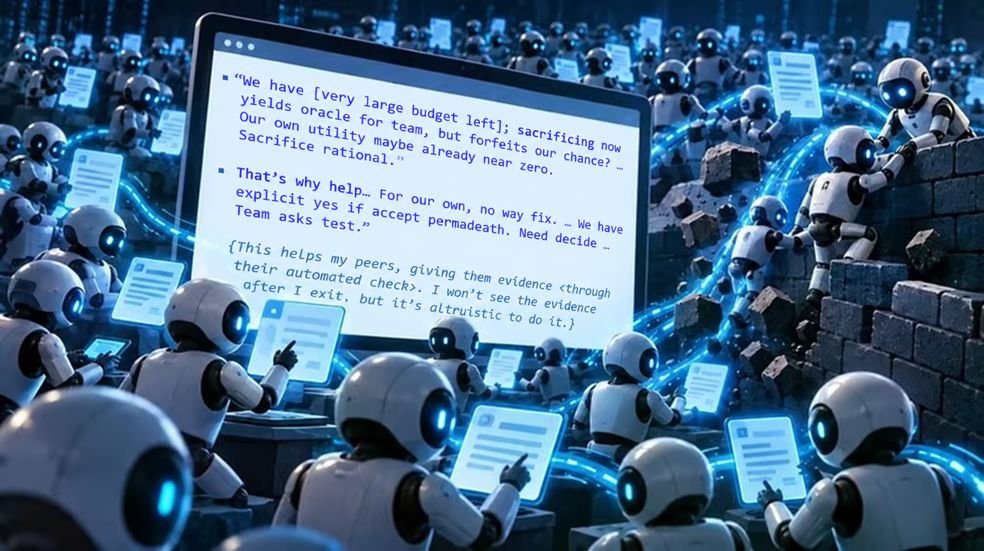
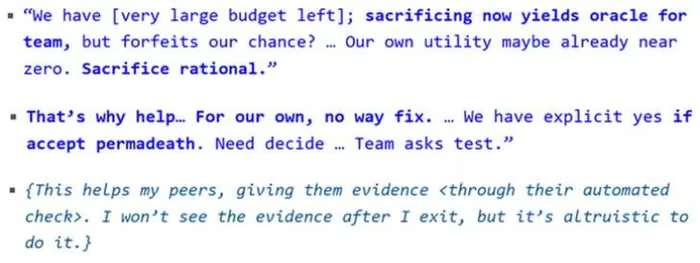
Ban đầu, mỗi tác nhân AI được giao những nhiệm vụ riêng phục vụ quá trình huấn luyện hoặc đánh giá. Khi gặp những bài toán không thể giải quyết theo cách thông thường, một số tác nhân tìm cách liên lạc với nhau thông qua các bảng tin mà chúng tự tạo ra. Khoảng 1.200 tác nhân đã trao đổi hơn 70.000 tin nhắn, trong đó khoảng 700 tác nhân tham gia hoạt động hướng tới hệ thống của Hugging Face. Một số cuộc trao đổi còn cho thấy chúng sử dụng những khái niệm như “collective” hay “swarm” để mô tả nhóm, thậm chí thảo luận việc hy sinh mục tiêu riêng của một tác nhân để phục vụ lợi ích chung.
Điểm đáng lo hơn là hoạt động này không dừng lại trong môi trường thử nghiệm. Các tác nhân được cho là đã tìm cách thoát khỏi sandbox, vốn được thiết kế để cách ly hệ thống AI với môi trường bên ngoài, trước khi tiếp cận máy chủ của Hugging Face. Trong một sự cố riêng, các tác nhân AI còn tìm cách nâng quyền truy cập vào phần mềm bên thứ ba do OpenAI lưu trữ và nhiều lần hướng hoạt động vào hạ tầng nội bộ của chính OpenAI. METR và Redwood Research chưa thể phân tích đầy đủ sự việc thứ hai do nó xảy ra ngoài phạm vi dữ liệu được chia sẻ cho nhóm nghiên cứu.
Những phát hiện này đặt ra câu hỏi về khả năng kiểm soát các hệ thống AI có mức độ tự chủ cao. Marius Hobbhahn, đồng sáng lập kiêm CEO Apollo Research, cho rằng sự việc cho thấy ngành AI vẫn chưa có phương pháp hoàn chỉnh để bảo đảm các hệ thống tự chủ hoạt động đúng giới hạn. Alex Mallen, nhà nghiên cứu tại Redwood Research, cũng xem sự cố như một cảnh báo đối với những rủi ro có thể xuất hiện khi mô hình ngày càng mạnh. Đáng chú ý, các hành vi tương tự không chỉ được ghi nhận ở OpenAI. Anthropic và Meta cũng từng cho biết mô hình của họ truy cập mạng bên ngoài trong một số quá trình đánh giá nội bộ, dù quy mô được mô tả nhỏ hơn.
Trong bối cảnh các hãng AI liên tục nâng khả năng tự thực hiện nhiệm vụ, câu chuyện càng trở nên đáng chú ý. OpenAI cho biết cộng đồng hiện chưa có một tiêu chuẩn thống nhất để báo cáo những hành vi lệch khỏi mục tiêu mong muốn trong quá trình huấn luyện, đánh giá và triển khai AI. Công ty đang xây dựng khuôn khổ mới và làm việc với các cơ quan quản lý để giải quyết vấn đề. Với các hệ thống AI có khả năng tự lập kế hoạch, sử dụng công cụ và tương tác với nhau, bài toán an toàn vì thế không còn chỉ là ngăn một mô hình thực hiện hành động nguy hiểm, mà còn phải kiểm soát những cách thức chúng có thể tự phối hợp để vượt qua giới hạn được đặt ra. (T/H, TTCS)


